Ausgangslage: Der unsichtbare Produktivitäts-Killer
Der Kunde, ein etablierter Anbieter von B2B-Cloud-Lösungen mit Sitz in London und etwa 150 Mitarbeitenden, stand vor einem klassischen, aber schmerzhaften Problem: Die Datenbasis im Customer Relationship Management (CRM) war stark fragmentiert. In der Praxis bedeutete das, dass Vertriebsmitarbeiter nicht selten bis zu 4 Stunden pro Woche damit verbrachten, fehlende Informationen manuell zu recherchieren oder doppelte Kontakte mühsam zu identifizieren. Diese Zeit fehlte ihnen dann für die eigentliche Wertschöpfung: das aktive Akquirieren von Neukunden und das Pflegen bestehender Beziehungen.
Der zentrale Schmerzpunkt lag weniger in der Software selbst, sondern in der Ineffizienz der Prozesse. Ineffiziente Lead-Verarbeitung durch unvollständige Datensätze führte dazu, dass potenzielle Interessenten oft zu spät oder gar nicht kontaktiert wurden. Hinzu kam eine fehlende Sichtbarkeit auf den Customer-Journey-Status im CRM, was die Koordination zwischen Marketing und Vertrieb erschwerte. Ein oft unterschätzter, aber kritischer Faktor war die hohe Fluktuation im Vertrieb, die teilweise auf die frustrierenden, manuellen Datenpflege-Aufwände zurückzuführen war. Neue Mitarbeiter bräuchten zu lange, um sich in das chaotische Datenbild einzuarbeiten, was die Onboarding-Zeit verlängerte und die Motivation senkte.
Herausforderungen im Detail
Beim ersten Blick auf die Datenlage stießen wir auf mehrere spezifische Hürden, die eine einfache „Sauberkeitsaktion“ nicht gelöst hätten. Zunächst war die Historie der Daten unglaublich heterogen. Über die Jahre waren verschiedene Quellen genutzt worden, von Excel-Listen über Legacy-Systeme bis hin zu manuellen Eingaben. Das führte zu Inkonsistenzen in der Formatierung von Adressen und Firmennamen, die eine automatische Deduplizierung zunächst unmöglich machten.
Zweitens gab es Widerstände im Vertrieb. Viele Vertriebsmitarbeiter hatten eigene, lokale Excel-Listen geführt, die sie als vertrauenswürdiger empfanden als das zentrale CRM. Die Überzeugung, dass das System ihnen Arbeit abnimmt, statt sie zu kontrollieren, war ein großer psychologischer Hebel, den wir setzen mussten. Drittens war die Integration der bestehenden Tools technisch komplexer als erwartet. Die APIs des alten CRM-Systems waren teilweise veraltet und verlangsamten den Datenfluss, was eine sorgfältige Middleware-Architektur erforderte, um Engpässe zu vermeiden.
Der Tech-Stack
Um diese Herausforderungen zu bewältigen, haben wir einen schlanken, aber robusten Tech-Stack aufgebaut, der auf Interoperabilität und Automatisierung setzt:
- Zentrales CRM-System: Die bestehende CRM-Plattform diente als Single Source of Truth. Wir haben die Feldstruktur optimiert und Pflichtfelder definiert, um die Datenqualität an der Quelle sicherzustellen.
- E-Mail-Verifizierungstool: Ein spezialisierter Dienst, der E-Mail-Adressen in Echtzeit auf Existenz und Lieferbarkeit prüft, um Bounce-Raten zu minimieren und die Reputation der Absender-Domains zu schützen.
- Business-Data-Enrichment-Dienst: Eine API-basierte Lösung, die fehlende Firmendaten (wie Branche, Mitarbeiteranzahl, Technologie-Stack) automatisch aus öffentlichen Quellen bezieht und an den Kontakt anreichert.
- Workflow-Automatisierungsplattform: Die zentrale Orchestrierungsschicht, die die Trigger (z. B. „Neuer Lead erstellt“) mit den Aktionen (z. B. „Daten anreichern“, „Status aktualisieren“) verknüpft und Fehlerprotokolle führt.
Umsetzung: Von der Analyse zur Automatisierung
Wir haben in einem 8-wöchigen Projekt einen automatisierten Datenbereinigungs-Prozess implementiert. Der Fokus lag dabei nicht auf der Einführung neuer Software, sondern auf der intelligenten Verbindung bestehender Tools mit einem zentralen Hub. Unser Ansatz war iterativ: Wir wollten schnell messbare Verbesserungen erzielen, um die Akzeptanz im Team zu steigern, bevor wir in die Tiefe der Legacy-Daten stiegen.
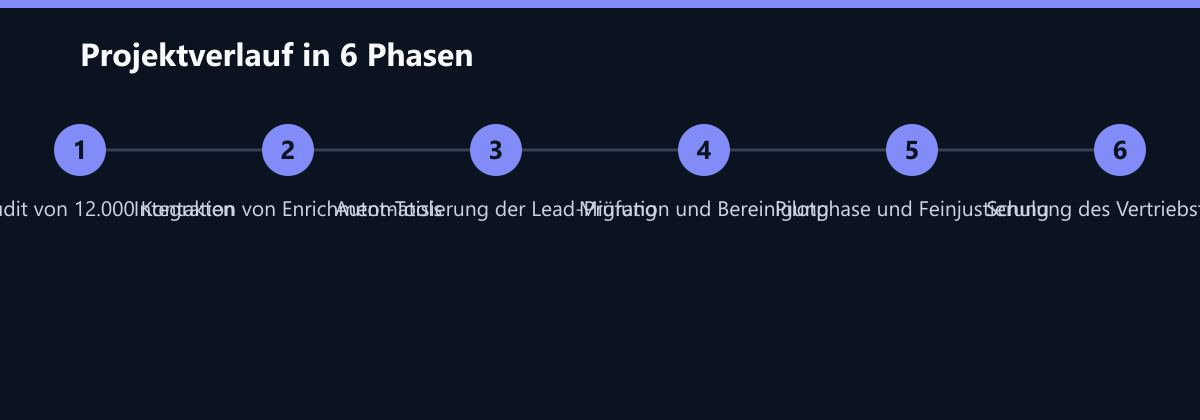
Die konkreten Schritte im Detail:
- Datenaudit (Woche 1-2): Wir haben eine Analyse von 12.000 Bestandskontakten durchgeführt. Ziel war es, die genaue Ausmaße der Duplikate und fehlenden Felder zu bestimmen. Dabei haben wir Muster in den Datenfalschmeldungen identifiziert, die auf fehlerhafte Importe aus der Vergangenheit hindeuteten.
- Tool-Integration (Woche 2-3): Wir haben das CRM an das E-Mail-Verifizierungstool und den Business-Data-Enrichment-Dienst angebunden. Hier lag der technische Schwerpunkt auf der Fehlerbehandlung: Was passiert, wenn die API nicht antwortet? Wir haben Retry-Mechanismen und manuelle Review-Queues eingerichtet.
- Automatisierung (Woche 4-5): Die Kernarbeit begann mit der Einrichtung der Workflows. Neue Leads werden nun sofort auf Vollständigkeit geprüft. Fehlende Daten werden automatisch angereichert, bevor der Lead an den Vertrieb übergeben wird. Gleichzeitig haben wir Regeln für die Deduplizierung festgelegt, die ähnliche Einträge automatisch zusammenfassen.
- Migration und Bereinigung des Bestands (Woche 5-6): Parallel zur Einrichtung der neuen Prozesse haben wir den Bestand bereinigt. Dies geschah in Phasen, um die Systemlast zu begrenzen. Wir haben duplizierte Kontakte zusammengeführt und fehlende Pflichtfelder über die Enrichment-APIs gefüllt, wo möglich.
- Pilotphase und Feinjustierung (Woche 6-7): Ein Teil des Vertriebsteams hat den neuen Prozess im Live-Betrieb getestet. Wir haben die Workflows basierend auf ihrem Feedback feinjustiert. Ein häufiger Punkt war die Geschwindigkeit der Datenanreicherung; wir haben die Priorisierung der Jobs optimiert, um Wartezeiten zu reduzieren.
- Schulung und Rollout (Woche 8): Zum Abschluss haben wir das gesamte Vertriebsteam geschult. Der Fokus lag nicht auf der technischen Bedienung, sondern auf dem Nutzen: Wie spare ich mir mit den sauberen Daten die tägliche Recherche? Wir haben Best Practices für die manuelle Eingabe von neuen, nicht automatisch anreicherbaren Daten erarbeitet.
Wie wir die Zahlen messen
Die Messung der Ergebnisse basierte auf einer Kombination aus systeminternen Logs und manuellen Umfragen, um sowohl die quantitative als auch die qualitative Seite abzubilden. Die Steigerung der Sales-Produktivität wurde durch die Anzahl der produktiven Vertriebsaktivitäten (Calls, Demos, Meetings) pro Mitarbeiter und Woche gemessen, verglichen mit dem Durchschnitt der drei Monate vor dem Projektstart. Die Reduktion der Zeit für manuelle Datenpflege wurde durch eine wöchentliche Self-Reporting-Umfrage im Vertrieb ermittelt, in der die geschätzte Zeit für Datenpflege angegeben wurde. Die Vollständigkeit der Pflichtfelder wurde direkt aus dem CRM-System gezogen, indem der Prozentsatz der Kontakte mit ausgefüllten Pflichtfeldern (Name, Firma, E-Mail, Position) berechnet wurde. Diese Methodik stellt sicher, dass die Zahlen nicht nur theoretisch, sondern im operativen Alltag verankert sind.
Ergebnis: messbare Produktivität
Nach der Stabilisierung des neuen Prozesses zeigte das CRM eine deutlich höhere Datenqualität. Die Vertriebsmitarbeiter konnten ihre Zeit für aktive Akquise nutzen, statt für Recherche. Die ersten drei Monate nach dem Rollout zeigten eine klare Trendwende. Die wichtigste Erkenntnis war, dass die Automatisierung nicht nur Zeit sparte, sondern auch die Qualität der Interaktionen mit Kunden verbesserte, da die Vertriebler besser vorbereitete Informationen vorliegen hatten.
Die wichtigsten KPIs nach 3 Monaten:
- 22 % Steigerung der Sales-Produktivität pro Kopf.
- 45 % Reduktion der Zeit für manuelle Datenpflege.
- 98 % Vollständigkeit der Pflichtfelder bei neuen Leads.
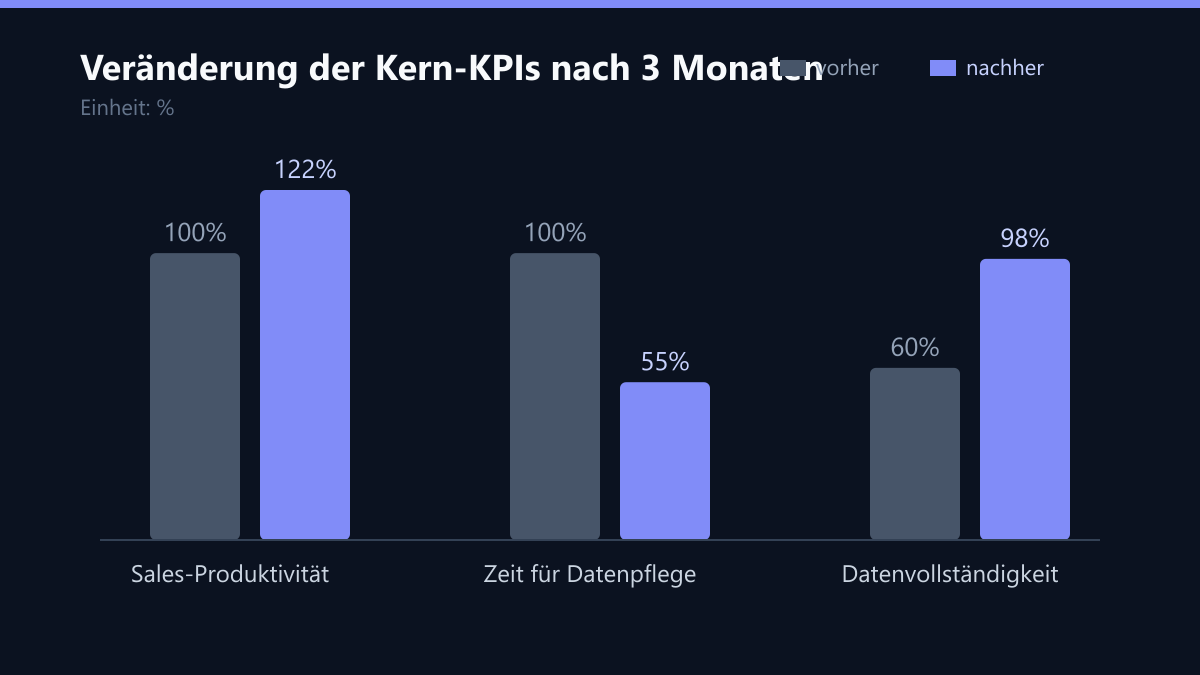
| Metrik | Vorher | Nachher |
|---|---|---|
| Datenqualität | 60 % | 98 % |
| Zeit für Recherche | 4 h/Woche | 1 h/Woche |
| Conversion Rate | 3.2 % | 4.1 % |
Besonders die Steigerung der Conversion Rate von 3,2 % auf 4,1 % zeigt, dass saubere Daten nicht nur intern, sondern auch extern Wirkung zeigen. Bessere Daten führen zu persönlicheren Ansprachen, was wiederum die Resonanz bei potenziellen Kunden erhöht.
Learnings und was wir heute anders machen würden
Der Erfolg lag weniger in der Software selbst, sondern in der Disziplin der Datenpflege. Eine einmalige Bereinigung reicht nicht; der automatische Check bei jedem neuen Lead ist entscheidend. Wir haben gelernt, dass die technische Lösung nur die Hälfte des Projekts ist; die andere Hälfte ist Change Management.
Kern-Erkenntnisse:
- Automatik schlägt Manpower: Manuelle Pflege ist zu langsam und fehleranfällig. Nur durch Automatisierung kann die Skalierbarkeit gewährleistet werden.
- Sales-Akzeptanz: Wenn das CRM Zeit spart, wird es vom Vertrieb aktiv genutzt. Der Fokus auf den unmittelbaren Nutzen für den Endnutzer ist entscheidend.
- Kontinuierlichkeit: Datenqualität ist ein laufender Prozess, kein einmaliges Projekt. Regelmäßige Audits und Anpassungen der Workflows sind notwendig.
Was wir heute anders machen würden: Erstens hätten wir das Change Management früher und intensiver starten sollen. Die Schulungen am Ende des Projekts waren notwendig, aber eine frühere Einbindung der Vertriebsmitarbeiter in die Gestaltung der Workflows hätte die Akzeptanz noch schneller gesteigert. Zweitens hätten wir die API-Limits des Enrichment-Dienstes im Vorfeld genauer getestet, um Engpässe in der Pilotphase zu vermeiden. Drittens hätten wir einen klareren Datenverantwortlichen (Data Owner) im Kundenunternehmen benennen sollen, der nach dem Projektabschluss die Verantwortung für die Pflege der Regeln übernimmt, um die Nachhaltigkeit sicherzustellen.