Ausgangslage: Das Problem der unklaren Sichtbarkeit
Der Kunde, ein B2B-SaaS-Anbieter mit Sitz in Seattle und 45 Mitarbeitern, stand vor einem klassischen Wachstumsproblem: Die Zahlen auf dem Papier sahen gut aus, aber die Realität im Vertrieb widersprach den Prognosen. Im Jahr 2023 erkannte das Management, dass die Umsatzprognosen für den US-Markt dauerhaft um 30 % über dem tatsächlichen Ergebnis lagen. Diese Diskrepanz war nicht nur ein statistisches Rauschen, sondern ein strukturelles Defizit, das die Planungssicherheit der gesamten Organisation gefährdete. Sales-Manager verließen sich bei ihren Schätzungen stark auf Bauchgefühl und persönliche Einschätzungen, während Marketing und Vertrieb an unterschiedlichen Datenquellen arbeiteten. Es fehlte eine gemeinsame Wahrheit.
Die technische Infrastruktur in HubSpot war unzureichend für die Komplexität des Marktes. Die Pipeline war unstrukturiert, mit zu grob definierten Stages, die wenig Aussagekraft über den tatsächlichen Reifegrad eines Deals boten. Es gab keine klaren Kriterien für den Übergang zwischen den Phasen, was dazu führte, dass Opportunities oft willkürlich vor- oder zurückgestuft wurden. Besonders kritisch war, dass kein Lead Scoring existierte. Das Sales-Team verbrachte wertvolle Zeit mit der Qualifizierung von Low-Value-Leads, während heiße Opportunities, die bereits ein hohes Engagement zeigten, in der Warteschleife lagen. Diese Ineffizienz führte nicht nur zu Frustration im Team, sondern auch zu verpassten Umsatzchancen im kompetitiven US-Markt.
Herausforderungen: Warum Standard-Lösungen nicht reichten
Die Implementierung einer neuen Strategie stieß auf drei konkrete Widerstände. Erstens war die Datenqualität in der bestehenden Datenbank mangelhaft. Viele Leads hatten unvollständige Firmenangaben, was eine präzise Segmentierung nach Firmengröße oder Branche erschwerte. Zweitens herrschte Widerstand im Vertrieb gegenüber neuen Regeln. Die Sales-Teams waren an die freie Interpretation der Pipeline-Statuses gewöhnt und befürchteten, durch strenge Kriterien an ihrer Eigenständigkeit eingeschränkt zu werden. Drittens fehlte es an einer klaren Definition, was ein „qualifizierter“ Lead überhaupt ist. Marketing definierte MQLs (Marketing Qualified Leads) basierend auf reinen Interaktionszahlen, während Vertrieb auf Budget und Bedarf achtete. Diese Asymmetrie führte dazu, dass viele MQLs von Sales als unqualifiziert abgelehnt wurden, was die Zusammenarbeit zusätzlich belastete.
Um diese Hürden zu überwinden, war ein Ansatz nötig, der nicht nur technologisch, sondern auch kulturell verankert wurde. Es reichte nicht aus, nur Tools zu konfigurieren; es musste ein gemeinsames Verständnis für den Wert der Daten geschaffen werden.
Der Tech-Stack
- HubSpot CRM: Als zentrale Datenquelle für die Verwaltung von Kontakten, Unternehmen und Opportunities. Wir nutzten die erweiterten Felder, um die neuen Scoring-Kriterien abzubilden.
- HubSpot Marketing Hub: Zur Konfiguration der automatisierten Journeys und zur Verfolgung der Lead-Interaktionen über verschiedene Kanäle hinweg.
- HubSpot Sales Hub: Für die strukturierte Pipeline-Ansicht und die Integration der Scoring-Punkte direkt in das Deal-Interface der Account Executives.
- Custom Reporting (HubSpot Native): Zur Erstellung der wöchentlichen Dashboards, die die Conversion-Raten je Stage visualisierten und Abweichungen sofort sichtbar machten.
- Excel/Sheets (Initial Audit): Für die manuelle Analyse der historischen Daten, um die Baseline-Kennzahlen vor der Implementierung zu bestimmen.
Umsetzung: Strukturierte Pipeline und automatisiertes Scoring
Der Projektstart erfolgte mit einer intensiven Audit-Phase. Wir analysierten die bestehenden Daten der letzten 12 Monate, um die tatsächlichen Conversion-Raten und Deal-Zyklen zu verstehen. Innerhalb von zwei Wochen definierten wir eine sechsstufige Pipeline, die den spezifischen Vertriebsprozess des Kunden abbildete. Jede Stage erhielt klare Eintritts- und Austrittskriterien. Beispielsweise durfte ein Deal nur in die Stage „Proposal Sent“ wechseln, wenn ein technischer Fit bestätigt und das Budget freigegeben war. Jeder Stage wurde ein spezifischer Indikator zugeordnet, wie „Demo gebucht“ oder „Security Review gestartet“, um Subjektivität zu eliminieren.
Parallel zur Pipeline-Strukturierung implementierten wir ein Lead-Scoring-Modell in HubSpot. Dieses Modell war kein statisches, sondern ein dynamisches System, das Punkte für bestimmte Aktionen vergab. Die Gewichtung basierte auf der historischen Analyse der Top-Performing-Deals. Folgende Kriterien wurden festgelegt:
- Hochwertige Interaktion: Der Download eines Whitepapers oder einer Fallstudie brachte +20 Punkte. Dies signalisierte ein tiefgehendes Interesse an der Lösung.
- Engagement: Mehr als 3 E-Mail-Öffnungen innerhalb von 7 Tagen führten zu +15 Punkten. Dies zeigte aktives Tracking der Kommunikation.
- Firmengröße: Unternehmen mit mehr als 50 Mitarbeitern erhielten +25 Punkte, da diese Zielgruppe das höchste Umsatzpotenzial bot.
Die Schwelle für die Übergabe an den Vertrieb wurde bei 60 Punkten angesetzt. Automatisierte Journeys führten Leads mit über 60 Punkten direkt an den zuständigen Account Executive, während Leads unter dieser Schwelle in einer Nurturing-Sequence verblieben, bis sie weitere Punkte sammelten. Diese Trennung war der Schlüssel, um die Kapazität des Sales-Teams zu schonen.
Zusätzlich richteten wir wöchentliche Reports ein, die die Conversion-Rate je Stage visualisierten. Diese Transparenz erlaubte es dem Management, Engpässe frühzeitig zu erkennen. Wenn beispielsweise die Conversion-Rate von Stage 2 zu Stage 3 plötzlich sank, konnte sofort nach der Ursache geforscht werden – sei es ein Problem im Pitch, im Pricing oder in der technischen Bewertung.
Wie wir die Zahlen messen
Die Messung der Ergebnisse basierte auf einer kohärenten Methodik, die vor dem Projektstart definiert wurde. Die Forecast-Genauigkeit wurde als Abweichung zwischen der prognostizierten und der tatsächlich erzielten Summe der Deals in einem Quartalszeitraum berechnet. Vorher lag diese Abweichung bei -30 % (die Prognose war zu hoch), was einer Genauigkeit von 70 % entsprach. Nach der Implementierung wurde die Prognose auf Basis der strukturierten Pipeline-Daten erstellt, was zu einer Abweichung von nur 3 % führte (97 % Genauigkeit).
Die Deal-Dauer wurde als Durchschnitt der Tage vom Erstkontakt (Lead Creation) bis zur Vertragsunterzeichnung (Closed Won) gemessen. Wir schlossen dabei Deals aus, die länger als 180 Tage dauerten, um Ausreißer zu minimieren. Die Conversion Rate wurde spezifisch für den Übergang von MQL zu SQL (Sales Qualified Lead) gemessen, da hier der größte Hebel durch das Scoring lag. Alle Daten wurden direkt aus HubSpot exportiert und in einem zentralen Dashboard konsolidiert, um Manipulationen durch einzelne Nutzer auszuschließen.
Ergebnis: 27 % genauere Forecasts und schnellere Deals
Nach drei Monaten der Implementierung zeigte sich ein deutlicher und messbarer Effekt. Die Forecast-Genauigkeit stieg von 70 % auf 97 %, was einer Verbesserung von 27 % entspricht. Die Sales-Manager konnten nun auf objektiven Daten statt auf Schätzungen basieren, was die Planungssicherheit für den CFO und die Geschäftsführung massiv erhöhte. Die durchschnittliche Deal-Dauer im US-Markt verkürzte sich von 94 auf 78 Tage, was einer Reduktion von 16 Tagen entspricht. Dies bedeutete, dass das Unternehmen schneller Umsatz generieren und Cashflow-Engpässe vermeiden konnte.
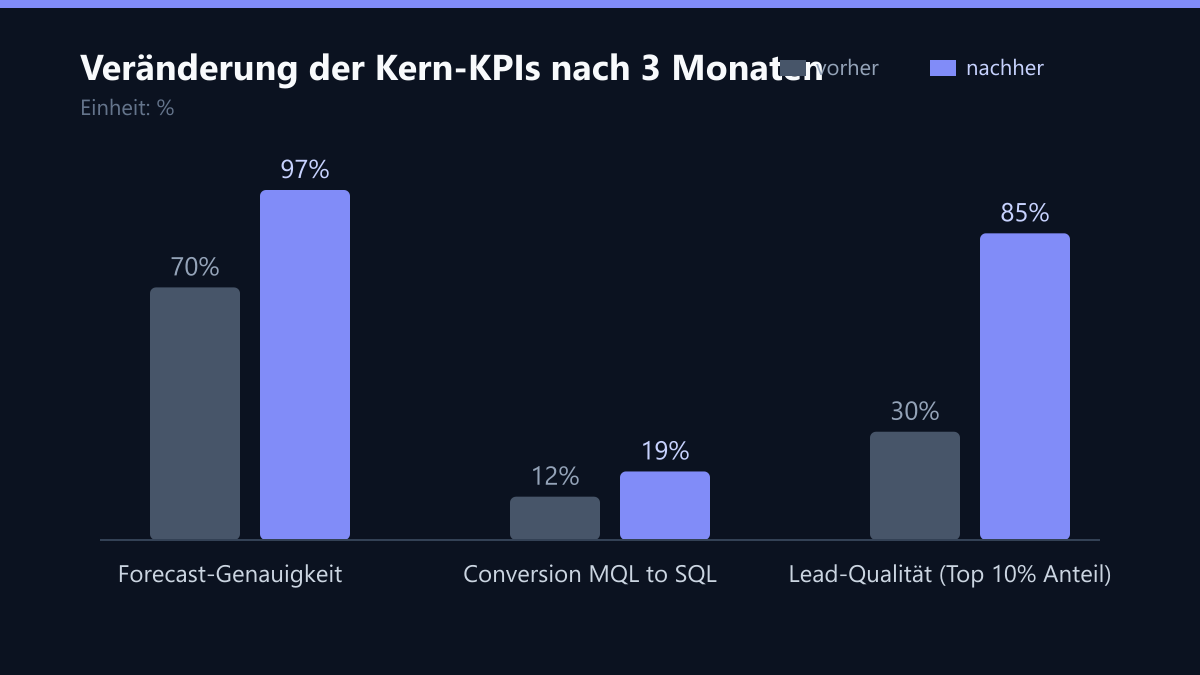
Die Conversion Rate von MQL zu SQL stieg von 12 % auf 19 %, was einem Anstieg von 7 Punkten entspricht. Dies bestätigte, dass das Scoring-Modell genau die richtigen Leads identifizierte. Die Sales-Teams meldeten zudem, dass sie 30 % mehr Zeit für aktive Akquise hatten, da Low-Value-Leads automatisch gefiltert und von Marketing betreut wurden. Diese qualitative Rückmeldung war ebenso wichtig wie die harten Zahlen, da sie die Akzeptanz der neuen Prozesse im Team sicherstellte.
Learnings: Datenqualität schlägt Volumen
Der entscheidende Faktor für den Erfolg war nicht die Menge der Leads, sondern deren Qualität. Durch das Scoring konnte sich das Team auf die Top 10 % der Leads konzentrieren, die ein signifikant höheres Conversion-Potenzial hatten. Ein weiteres zentrales Learning war, dass klare Stage-Definitionen essenziell sind. Ohne diese hätte das Scoring keinen Mehrwert gebracht, da der Status der Opportunities weiterhin subjektiv interpretiert worden wäre. Die Strukturierung der Pipeline schuf das Fundament, auf dem das Scoring aufbauen konnte.
Ein oft übersehener Aspekt war die enge Zusammenarbeit zwischen Marketing und Vertrieb während der Konfigurationsphase. Die Definition der Scoring-Punkte war ein iterativer Prozess, bei dem beide Abteilungen ihre Perspektiven einbrachten. Marketing verstand die technischen Interaktionen, während Vertrieb die kaufmännischen Kriterien kannte. Nur durch diese Ko-Kreation wurde ein Modell erstellt, das von beiden Seiten akzeptiert und genutzt wurde.
Was wir heute anders machen würden
Obwohl das Projekt erfolgreich war, gibt es zwei Punkte, die wir in zukünftigen Projekten früher adressieren würden. Erstens hätten wir die Datenbereinigung (Data Hygiene) noch aggressiver vor der Scoring-Implementierung durchgeführt. Die unvollständigen Firmenangaben führten in den ersten zwei Wochen zu einigen Fehlklassifizierungen, die manuell korrigiert werden mussten. Ein automatisierter Deduplizierungs- und Anreicherungsschritt (z. B. via Clearbit oder ZoomInfo) hätte diese Reibungsverluste reduziert.
Zweitens hätten wir die Schulung der Sales-Teams intensiver gestaltet. Einige Account Executives neigten dazu, das Scoring zu ignorieren, wenn sie subjektiv einen Lead als „gut“ einschätzten. Eine stärkere Einbindung in die Definition der Kriterien und regelmäßige Review-Sessions in den ersten Monaten hätten die Compliance mit dem neuen Prozess erhöht. In Zukunft integrieren wir eine „Scoring-Compliance“ in die wöchentlichen Sales-Reviews, um sicherzustellen, dass die Datenqualität durch konsequentes Verhalten im CRM aufrechterhalten wird.