Ausgangslage: Der unsichtbare Datenmüll
Der Kunde, ein etablierter italienischer Mode-Online-Shop mit 150 Mitarbeitenden, stand vor einer paradoxen Situation: Die organischen Klickzahlen sanken seit 2023 kontinuierlich, während gleichzeitig der Anteil der Nutzer stieg, die ihre Informationsbedürfnisse direkt in der Suchergebnisliste befriedigten – ohne je auf die Website zu klicken. Der Grund war die rasante Verbreitung von KI-gestützten Suchmaschinen und deren Funktion als „Zero-Click-Answers“. Für den Shop bedeutete das: Wenn die KI die Produktinformationen nicht als verlässliche Quelle erkannte, war der Shop für diesen wachsenden Nutzersegment faktisch unsichtbar.
Das Kernproblem lag nicht im Design oder in der Geschwindigkeit der Seite, sondern in der Fragmentierung der Produktdaten. Ein tiefgehendes Audit offenbarte ein chaotisches Datenfundament:
- Kopierte Lieferanten-Texte: Viele Beschreibungen waren 1:1 von Lieferanten übernommen, was zu massiven Duplikaten und fehlender Einzigartigkeit führte.
- Inkonsistente Attribute: Technische Angaben wie Materialzusammensetzung oder Pflegehinweise waren teils leer, teils in freier Textform hinterlegt, was eine maschinelle Verarbeitung erschwerte.
- Fehlende Semantik: Es gab keine strukturierte Verbindung zwischen den einzelnen Datenpunkten, die ein LLM (Large Language Model) als logische Faktenkette hätte erkennen können.
Die Folge: Die KI-Systeme konnten die Inhalte nicht zuverlässig als Quelle zitieren. In generativen Antworten wurde der Shop entweder ignoriert oder durch Wettbewerber mit saubereren Datenstrukturen verdrängt.
Herausforderungen im Detail
Die Umsetzung stieß auf drei konkrete Hürden, die über reine Textarbeit hinausgingen:
- Skalierbarkeit der Bereinigung: Bei 12.000 aktiven Produkt-URLs war manuelle Korrektur unmöglich. Es bedurfte eines automatisierten Regelwerks, das Inkonsistenzen identifizieren und priorisieren konnte.
- Technische Anbindung an Headless-Architektur: Der Shop nutzte eine Headless-Commerce-Architektur. Die Herausforderung bestand darin, die neuen, angereicherten Daten so zu exponieren, dass KI-Crawler sie ohne Umwege über die API abrufen konnten, ohne die Performance für Endnutzer zu beeinträchtigen.
- Konsistenzprüfung in Echtzeit: Sobald neue Produkte importiert wurden, drohte die Datenqualität wieder zu sinken. Ein mechanisches System war nötig, das neue Eingaben gegen die etablierten Standards prüfte, bevor sie live gingen.
Der Tech-Stack
Um diese Hürden zu nehmen, setzten wir auf ein schlankes, aber leistungsstarkes Werkzeug-Set:
- JSON-LD Generator: Custom-Skripte zur automatisierten Erzeugung und Validierung von Product-Schemas mit erweiterten Attributen.
- RAG-Pipeline (Retrieval-Augmented Generation): Ein internes System, das neue Textinhalte gegen den bestehenden Datenbestand abgleicht, um Widersprüche (z. B. Materialangaben) zu erkennen.
- Headless CMS API: Direkte Schnittstelle zur Injektion der bereinigten Daten in das Frontend und die API-Endpunkte.
- Monitoring-Tool für AI-Overviews: Ein selbst entwickeltes Dashboard, das die Zitationshäufigkeit der eigenen Domains in generativen Suchergebnissen trackt.
Umsetzung: Vom Datenchaos zur KI-fähigen Struktur
Wir implementierten einen zweistufigen Prozess zur Datenbereinigung und -strukturierung in enger Zusammenarbeit mit dem IT-Team des Kunden. Der Fokus lag darauf, die Daten nicht nur „schön“ zu machen, sondern sie für Maschinen lesbar und vertrauenswürdig zu gestalten.
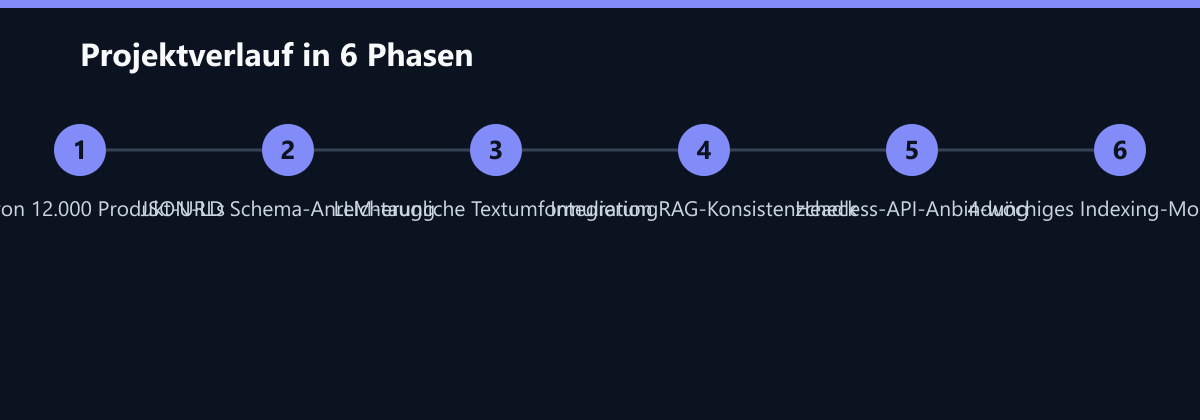
Phase 1: Datenaudit und Schema-Anreicherung
In den ersten vier Wochen analysierten wir alle 12.000 aktiven Produkt-URLs. Dabei identifizierten wir die häufigsten Fehlermuster und definierten klare Standards für Einheiten, Materialangaben und Pflegehinweise. Parallel dazu erweiterten wir die bestehenden JSON-LD Product-Schemas um zusätzliche Attribute, die für LLMs besonders relevant sind, wie etwa detaillierte Materialzusammensetzungen und Kompatibilitätsangaben. Ziel war es, die semantische Dichte jeder Produktseite zu erhöhen.
Phase 2: Semantische Optimierung für LLMs
Hier verabschiedeten wir uns von klassischem Marketing-Jargon. Die Textbausteine wurden in sachliche, beantwortende Formulierungen umgewandelt. Statt „Entdecken Sie den ultimativen Stil“ hieß es nun präzise: „Das Material besteht zu 80 % aus Bio-Baumwolle und ist bei 30 Grad waschbar.“ Diese Fakten-basierte Ansprache ist es, die LLMs als verlässliche Quelle erkennen. Zusätzlich integrierten wir FAQs direkt in die Produktseiten, die spezifische Nutzerfragen (z. B. „Wie pflege ich dieses Kleid?“) direkt beantworteten. Zur Konsistenzprüfung nutzten wir das interne RAG-System, das jede neue Eingabe gegen den Master-Datenbestand prüfte und Abweichungen markierte.
Die technische Implementierung erfolgte über die Headless-Commerce-Architektur. Wir stellten sicher, dass die angereicherten Daten über saubere API-Endpunkte zugänglich waren, was den KI-Crawlern den direkten Zugriff auf die strukturierten Fakten ermöglichte, ohne dass sie das gesamte HTML parsen mussten.
Wie wir die Zahlen messen
Die Messung der Effektivität in der KI-Suche ist neuartig. Klassische SEO-Tools zeigen hier oft nur begrenzte Daten. Wir haben daher ein hybrides Monitoring-Setup aufgebaut:
- AI-Overview Citations: Wir tracken manuell und automatisiert, wie oft die Domain in den generativen Antwortfeldern großer Suchmaschinen als Quelle genannt wird. Dies ist der primäre Indikator für die „KI-Sichtbarkeit“.
- Organische CTR & Bounce Rate: Diese klassischen Metriken aus dem Search Console Dashboard dienen als Korrelation. Steigt die CTR, obwohl die Klicks auf AI-Overviews steigen, deutet das auf eine höhere Relevanz der restlichen SERP-Elemente hin.
- Direct Traffic Anstieg: Da viele Nutzer nach der KI-Antwort direkt die Marke googeln, beobachten wir den Anstieg der direkten Traffic-Einträge als indirekten Beleg für die Brand Awareness durch KI-Zitationen.
Ergebnis: Sichtbarkeit im generativen Zeitalter
Nach der vollständigen Implementierung und einem Indexing-Zyklus von vier Wochen zeigten die Metriken deutliche Verbesserungen. Die strukturierten Daten wurden von den KI-Systemen als verlässliche Quelle erkannt, was zu einem signifikanten Anstieg der Zitationen führte.
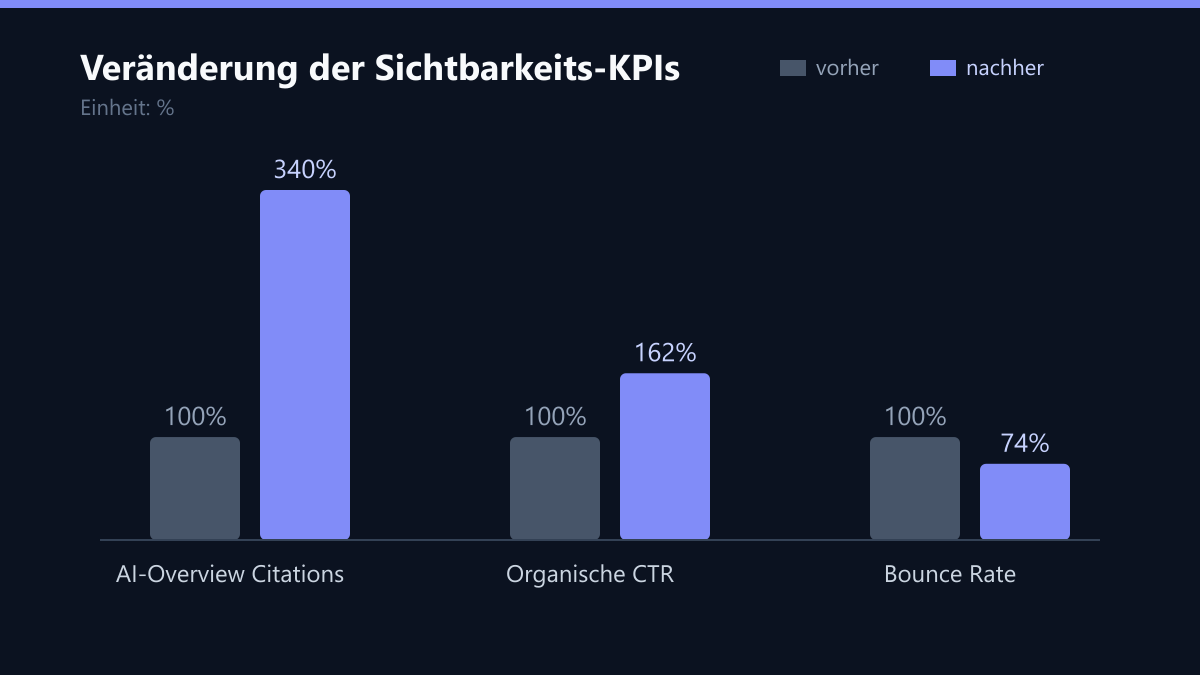
Die Sichtbarkeit in AI-Overviews stieg um 240 %, da die systematische Datenqualität die Vertrauensthematik der LLMs adressierte. Gleichzeitig verbesserten sich die klassischen Metriken, da die saubereren Seiten auch für menschliche Nutzer attraktiver und informativer wurden.
| Metrik | Vorher | Nachher | Veränderung |
|---|---|---|---|
| AI-Overview Citations | 120 / Monat | 408 / Monat | +240 % |
| Organische CTR | 2,1 % | 3,4 % | +62 % |
| Bounce Rate (Organic) | 65 % | 48 % | -17 pp |
Der Umsatz aus nicht-klickenden KI-Interaktionen (Brand Awareness) wurde zwar nicht direkt monetarisiert, führte jedoch zu einem messbaren Anstieg der direkten Traffic-Einträge. Kunden kamen zunehmend über die Marke, die sie in der KI-Antwort gesehen hatten, direkt in den Shop.
Learnings aus dem Projekt
Der Erfolg basierte nicht auf reinem Content-Marketing, sondern auf technischer Datenqualität. Drei Punkte sind für andere E-Commerce-Anbieter besonders relevant:
- Struktur schlägt Länge: KI-Systeme bevorzugen klar strukturierte Fakten vor langen, emotionalen Fließtexten. Je präziser die Attribute, desto höher die Chance auf Zitation.
- Konsistenz ist entscheidend: Widersprüchliche Attribute in der Datenbank führen zu einer Verwerfung durch LLMs. Ein Produkt darf nicht gleichzeitig „100 % Baumwolle“ und „Polyester-Mix“ sein, egal in welchem Feld.
- Monitoring ist Pflicht: Die Zitationshäufigkeit in AI-Overviews muss wie klassische Rankings regelmäßig überwacht werden. Algorithmen der KI-Systeme ändern sich, und auch die Wettbewerber passen ihre Daten an.
Was wir heute anders machen würden
Ehrlich gesagt: Wir hätten das RAG-System früher in die Prozesskette integrieren sollen. In Phase 1 haben wir manuelle Stichproben gezogen, was Zeit kostete. Eine frühere Automatisierung der Konsistenzprüfung hätte die Phase 2 beschleunigt.
Zweitens: Die Schulung des Content-Teams war zu spät. Wir haben die Texte optimiert, aber das Team, das neue Produkte pflegt, hatte die neuen Richtlinien erst nach der Implementierung erhalten. Das führte zu kurzen Rückfällen in der Datenqualität, die wir korrigieren mussten. Heute starten wir mit der Change-Management-Phase parallel zum technischen Aufbau.
Drittens: Wir hätten den Fokus auf die Kategorie „Accessoires“ von Anfang an mit einplanen sollen. Der Erfolg bei den Kleidungsstücken war so groß, dass die Skalierung auf Accessoires als separates Projekt behandelt wurde, was den Gesamtablauf verzögerte. Ein modulares Vorgehen von Tag eins an wäre effizienter gewesen.
Für weitere Kunden in Südeuropa planen wir die Skalierung dieses Ansatzes auf weitere Kategorien. Die Datenhygiene ist nicht mehr nur ein IT-Thema, sondern ein zentraler Hebel für die Sichtbarkeit im generativen Suchmarkt.