Die Ausgangslage: Datenverlust als Wachstumshemmnis
Die Kundin, eine wachsende D2C-Marke für Nahrungsergänzungsmittel mit Sitz in Kalifornien, stand vor einem klassischen Dilemma des modernen E-Commerce: Das organische Wachstum war vorhanden, aber die Skalierung über bezahlte Kanäle geriet ins Stocken. Der Grund lag nicht in der Produktqualität, sondern in der Datenbasis. Durch iOS-14-Updates und strengere Datenschutzrichtlinien in den USA gingen 40% der Conversion-Events verloren, bevor sie die Ad-Plattformen erreichten.
Das bestehende Marketing-Mix-Modell basierte auf einer simplen First-Click-Attribution. Diese Methode unterbewertete die Performance bezahlter Social-Media-Kampagnen massiv, da sie den gesamten Erfolg dem ersten Klick zuschrieb, oft ein organischer Touchpoint. Das Marketing-Team aus 12 Personen konnte die Budgetallokation nicht datenbasiert steuern. Die Konsequenz war deutlich: eine Steigerung der Customer Acquisition Cost (CAC) um 22% im Vorjahr. Ohne valide Datenbasis war keine Skalierung des Paid-Ad-Budgets möglich, ohne die Marge der Marke zu gefährden. Die Führungsebene suchte nach einer Lösung, die nicht nur Symptome lindert, sondern die Datenarchitektur fundamental neu aufsetzt.
Konkrete Herausforderungen
Bevor wir mit der technischen Umsetzung begannen, identifizierten wir drei zentrale Herausforderungen, die eine einfache Anpassung des bestehenden Setups unmöglich gemacht hätten:
- Fragmentierte Datenquellen: Klicks, Conversions und CRM-Daten existierten in isolierten Silos. Es gab keinen einheitlichen “Single Source of Truth” für die Performance-Messung.
- Mangelnde Attributionstiefe: Das First-Click-Modell ignorierte Multi-Touch-Journeys. Kunden, die über mehrere Kanäle interagierten, wurden falsch zugeordnet, was zu ineffizienten Budgetentscheidungen führte.
- Skalierbarkeitsgrenzen des Browser-Trackings: Selbst mit Best-Practice-Implementierungen am Client-Ende war der Datenverlust durch Ad-Blocker und Browser-Policies nicht hinreichend zu kompensieren.
Der Tech-Stack
Um diese Herausforderungen zu lösen, wählten wir einen Tech-Stack, der auf Zuverlässigkeit und API-Native-Fähigkeit setzt:
- Server-Side-Tracking-Layer: Ein dedizierter Server zur Umleitung und Bereinigung aller Event-Daten vor dem Versand an die Ad-Plattformen.
- HubSpot CRM: Als zentrale Datenbank für Kundeninteraktionen, Bestellhistorie und Segmentierung.
- Meta CAPI & Google Ads API: Zur direkten, server-seitigen Übermittlung der Conversion-Events.
- TikTok Pixel (Server-Side): Zur Sicherstellung der Datenqualität auch auf dem schnell wachsenden Video-Kanal.
- Data-Driven-Attribution-Engine: Ein Algorithmus, der Multi-Touch-Interaktionen statistisch gewichtet und die Budgetverteilung dynamisch anpasst.
Umsetzung: Von der Infrastruktur zur Strategie
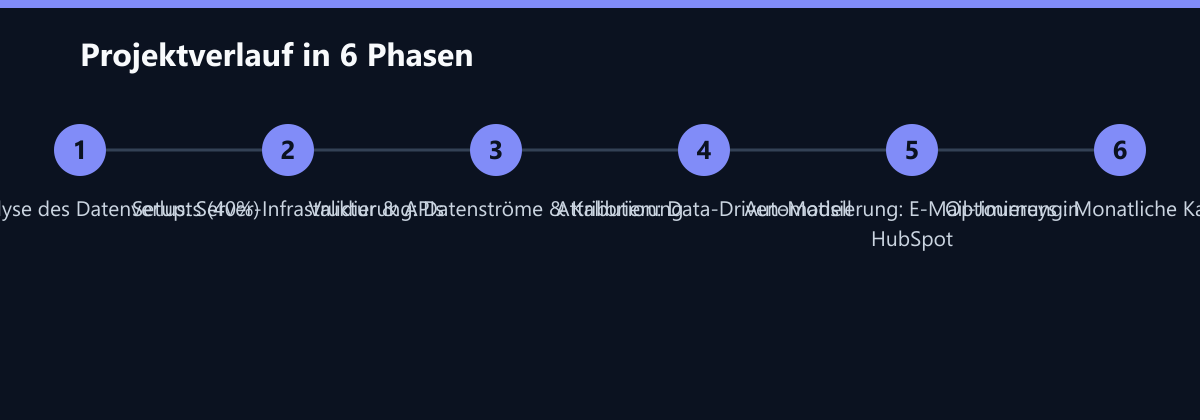
Die Implementierung war kein Big-Bang-Rollout, sondern ein strukturierter Prozess in sechs Wochen. Wir begannen mit der Analyse des bestehenden Datenflusses, um alle Bruchstellen zu identifizieren. Der Fokus lag von Anfang an auf der sauberen Verbindung von CRM- und Ad-Plattform-Daten, da dies der größte Hebel für die Genauigkeit der Lookalike-Audiences war.
Kernbausteine der Lösung:
- Event Forwarding: Wir implementierten eine Logik, die alle Klick- und Conversion-Events vom Frontend über einen dedizierten Server an Meta, Google Ads und TikTok umleitet. Dies sicherte die Datenintegrität unabhängig von Browser-Einschränkungen.
- CRM-Integration: Die Anbindung des Customer-Relationship-Managements (HubSpot) via API erlaubte es, Bestandskunden direkt mit Lookalike-Audiences zu verknüpfen. Statt generischer Zielgruppen nutzten wir die tatsächlichen Verhaltensdaten unserer wertvollsten Kunden.
- Lead Scoring & Journeys: Parallel zum Tracking-Setup bauten wir automatisierte E-Mail-Journeys für Warenkorb-Abbrüche und Reaktivierung inaktiver Kunden auf. Diese Journeys wurden direkt an die neuen, präziseren Segmente gekoppelt.
Die technische Implementierung dauerte 6 Wochen. In Woche 1-2 erfolgte das Setup der Server-Infrastruktur und der API-Verbindungen. Hier lag der Schwerpunkt auf der Latenzminimierung, um sicherzustellen, dass die Events in Echtzeit bei den Ad-Plattformen ankommen. Woche 3-4 dienten der Validierung der Datenströme und der Kalibrierung des Attributionsmodells. Wir verglichen die server-seitigen Daten mit den bisher bekannten Werten, um Abweichungen zu identifizieren und zu korrigieren. Woche 5-6 wurden die Marketing-Automation-Journeys in HubSpot konfiguriert und getestet, um sicherzustellen, dass die neuen Segmente korrekt ausgelöst wurden.
Wir definierten ein Data-Driven-Attributionsmodell, das Multi-Touch-Interaktionen über alle Kanäle hinweg gewichtet. Dies ersetzte die statische First-Click-Logik vollständig. Das Modell lernte kontinuierlich, welche Kanäle zur Konversion beitrugen, und verteilte den “Credit” entsprechend der tatsächlichen Wirkung.
Wie wir die Zahlen messen
Um die Wirksamkeit der Maßnahmen objektiv zu belegen, haben wir ein Messkonzept entwickelt, das auf drei Säulen beruht:
- Server-Side-Event-Log: Wir protokollieren jeden Event, der den Server verlässt, und vergleichen die Anzahl der versendeten Events mit der Anzahl der von den Ad-Plattformen bestätigten Conversions. Dies gibt uns einen exakten Einblick in die Datenqualität.
- Kohorten-Analyse im CRM: Wir tracken nicht nur den Umsatz, sondern die Lebenszyklus-Wertigkeit (LTV) der Kunden, die über die neuen Journeys akquiriert oder reaktiviert wurden. Dies zeigt, ob die neuen Kanäle langfristig profitabel sind.
- A/B-Testing der Budgetallokation: Wir haben die Budgets schrittweise verschoben und die ROAS-Änderungen in Echtzeit beobachtet. So konnten wir kausale Zusammenhänge zwischen der Attribution-Änderung und der Performance-Steigerung herstellen.
Ergebnis: Skalierung mit Profitabilität
Nach der vollständigen Implementierung und einer Stabilisierungsphase von 30 Tagen zeigte sich ein deutlicher Anstieg der Kampagneneffizienz. Die Ad-Plattformen konnten ihre Algorithmen deutlich schneller optimieren, da vollständige Conversion-Daten vorlagen. Die genauen Zahlen nach 6 Monaten Betrieb:
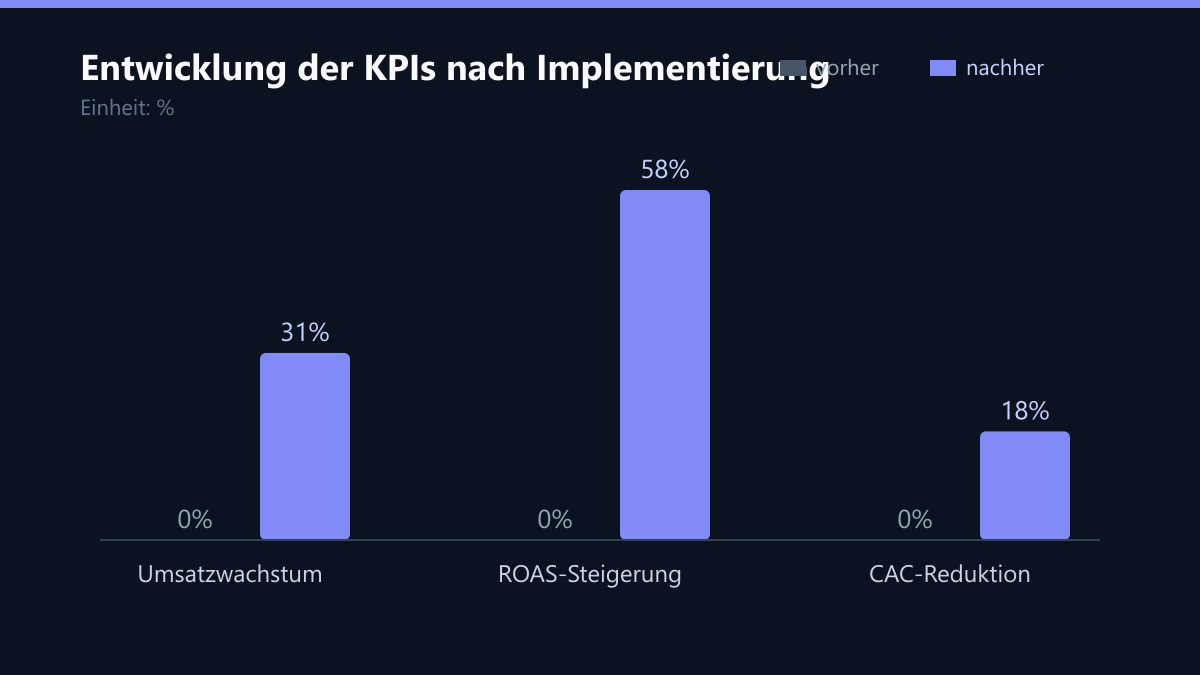
- Umsatzwachstum: +31% im Vergleich zum Vorjahreszeitraum.
- ROI-Steigerung: Der Return on Ad Spend (ROAS) erhöhte sich von 2,4 auf 3,8.
- CAC-Reduktion: Die Customer Acquisition Cost sank um 18%, da die Budgets auf die tatsächlich wirksamsten Kanäle verschoben wurden.
- E-Mail-Performance: Die Öffnungsrate der automatisierten Journeys lag bei 42%, der Umsatzanteil aus E-Mail-Kanälen stieg auf 28% des Gesamtumsatzes.
Die server-seitige Datenqualität ermöglichte es, Lookalike-Audiences mit einer Genauigkeit von über 90% zu erstellen. Diese Präzision führte dazu, dass die bezahlten Kampagnen weniger “Verschwendung” durch irrelevante Zielgruppen hatten. Die folgende Tabelle fasst die Kern-KPIs zusammen:
| Metrik | Vorher | Nachher | Veränderung |
|---|---|---|---|
| ROAS | 2,4 | 3,8 | +58% |
| CAC | $45,00 | $36,90 | -18% |
| Umsatzanteil E-Mail | 12% | 28% | +16 pp |
Learnings und strategische Implikationen
Der größte Hebel war nicht das Tracking selbst, sondern die Kopplung an das CRM. Ohne die direkte Anbindung der Bestandskundendaten an die Ad-Plattformen wäre die Qualität der Lookalike-Audiences nicht erreicht worden. Dies unterstreicht, dass Tracking nicht isoliert betrachtet werden darf, sondern Teil eines ganzheitlichen Daten-Ökosystems sein muss.
- Datensouveränität zahlt sich aus: Server-seitiges Tracking eliminierte den Datenverlust durch Browser-Blocker vollständig. Dies gab dem Marketing-Team das Vertrauen, wieder aggressiver in bezahlte Kanäle zu investieren.
- Attribution ist dynamisch: Das Data-Driven-Modell musste monatlich neu kalibriert werden, um saisonale Schwankungen im Supplement-Markt zu berücksichtigen. Was im Januar funktioniert, muss im Dezember nicht gelten.
- E-Mail als profitabler Kanal: Durch die saubere Segmentierung im CRM konnte E-Mail-Marketing vom reinen Informationskanal zum Umsatzkanal transformiert werden. Die hohen Öffnungsraten zeigten, dass die Kunden die personalisierten Inhalte schätzten.
Was wir heute anders machen würden
Rückblickend gibt es zwei Punkte, die wir in einem ähnlichen Projekt anders angehen würden:
- Frühere CRM-Hygiene: Wir hätten die Datenqualität im HubSpot-CRM noch intensiver vor der Integration geprüft. Kleine Inkonsistenzen in der Kunden-Identifikation (z. B. Dopplungen) haben in der Anfangsphase die Lookalike-Genauigkeit leicht beeinträchtigt.
- Kontinuierliche Schulung des Teams: Die Umstellung von First-Click auf Data-Driven Attribution erfordert ein Umdenken im Marketing-Team. Wir hätten mehr Zeit in Workshops investiert, um die neuen Kennzahlen und deren Interpretation zu verankern, anstatt sie nur technisch zu implementieren.
Die Kombination aus technischer Infrastruktur und strategischer Automatisierung hat die Skalierungsfähigkeit der Marke nachhaltig gesichert. Der Fall zeigt, dass im D2C-Bereich nicht nur die Kreativität der Ads zählt, sondern die Qualität der Daten, die hinter den Kulissen fließen.