Die wachsende Ineffizienz im Amazon-Marketing
Der Kunde, ein etablierter D2C-Beauty-Hersteller mit Sitz in München und 45 Mitarbeitenden, stand vor einem klassischen Problem des skalierenden E-Commerce: Das Budget für Amazon Ads wuchs, aber die Effizienz sank. Trotz steigender Ausgaben für Werbung stieg der Average Cost of Acquisition (ACoA) kontinuierlich an, während die Sichtbarkeit in relevanten Nischen-Kategorien stagnierte. Die internen Teams kämpften mit einer wachsenden Datenlast, die manuell kaum noch zu bewältigen war. Es fehlte an der Granularität, um die Masse an Suchanfragen sinnvoll zu segmentieren. Broad-Keywords wurden pauschal gebucht, was zu hohen Kosten für irrelevante Klicks führte, während hochkonvertierende Long-Tail-Phrasen ungenutzt blieben. Die monatlichen Reports aus dem Seller Central waren zu komplex, um ohne strukturierten Prozess in priorisierte Handlungsempfehlungen übersetzt zu werden.
Konkrete Herausforderungen vor der Optimierung
Um die Situation greifbar zu machen, haben wir vier zentrale Schmerzpunkte identifiziert, die den bisherigen Erfolg blockierten:
- Fehlende Datenverknüpfung: Suchdaten aus Brand Analytics und Verkaufsdaten aus den Kampagnen-Reports existierten isoliert voneinander. Es gab keinen direkten Bezug zwischen einem Suchbegriff und seinem tatsächlichen Umsatzbeitrag.
- Manuelle Priorisierung: Das Team verbrachte Stunden damit, tausende Suchbegriffe manuell durchzugehen. Bei über 500 aktiven Keywords war eine manuelle Differenzierung zwischen „High-Intent“ und „Low-Intent“ nicht mehr skalierbar.
- Budget-Lecks durch Broad-Matches: Fehlende negative Keyword-Listen in den breiten Kampagnen führten dazu, dass das Budget für irrelevante Suchanfragen verbrannt wurde, die keine Conversion generierten.
- Fehlende Agilität: Ohne einen automatisierten Feedback-Loop konnten Bidding-Strategien nicht in Echtzeit angepasst werden. Änderungen erfolgten oft mit Wochenverzug, basierend auf veralteten Eindrücken.
Der Tech-Stack: Tools für datengetriebene Entscheidungen
Für die Umsetzung nutzten wir einen spezifischen Stack, der auf Automatisierung und semantische Analyse setzt:
- Amazon Brand Analytics & Search Term Reports: Als primäre Datenquelle für Suchvolumen, Klicks und Conversion-Verhalten.
- Python (Pandas & Scikit-learn): Für die Datenbereinigung, Normalisierung und die Ausführung des semantischen Clustering-Algorithmus.
- CRM-System des Kunden: Diente als zentrale Anbindung, um die optimierten Keyword-Cluster direkt mit den Customer-Lifetime-Value-Daten zu verknüpfen.
- Amazon Ads API: Zur automatisierten Synchronisation der neuen Kampagnen-Struktur, Gebote und negativen Keywords.
Wie wir die Zahlen messen
Um die Effektivität der Maßnahmen objektiv zu belegen, haben wir einen strengen Messrahmen definiert. Wir haben eine Basisperiode von 90 Tagen vor der Implementierung als Referenzwert herangezogen. Die Kennzahlen wurden nicht nur auf Kampagnenebene, sondern auf Cluster-Ebene aggregiert, um die Wirkung der Segmentierung präzise zu isolieren. Die ACoS-Berechnung basierte auf den tatsächlichen Netto-Umsätzen, die über das CRM zurückgemeldet wurden, um Verzerrungen durch Retouren oder Nicht-Zustellungen auszuschließen. Die Conversion-Rate wurde als Verhältnis von Bestellungen zu Klicks in den spezifischen Clustern berechnet. Durch die tägliche Datenerfassung via API konnten wir Schwankungen sofort erkennen und den 60-Tage-Vergleich nach dem Rollout statistisch signifikant absichern.
Umsetzung: Vom Datenchaos zur präzisen Clusterung
Die Implementierung erfolgte in einem agilen Prozess über drei Wochen. Wir haben nicht versucht, die bestehende Kampagnenstruktur komplett zu ersetzen, sondern schichteten die Optimierung darüber hinweg. Der Fokus lag auf der Verbindung von Suchdaten mit den tatsächlichen Conversion-Erfolgszahlen der letzten 90 Tage. In der ersten Phase extrahierten wir alle Search Term Reports und Brand Analytics Insights. Diese rohen Daten wurden bereinigt, indem Tippfehler korrigiert und offensichtlich irrelevante Suchbegriffe (z. B. reine Markenwettbewerber ohne Kaufabsicht) gefiltert wurden. Die Daten wurden anschließend mit historischen Performance-Metriken wie CTR, CVR und ACoA angereichert, um ein vollständiges Bild pro Keyword zu erhalten.
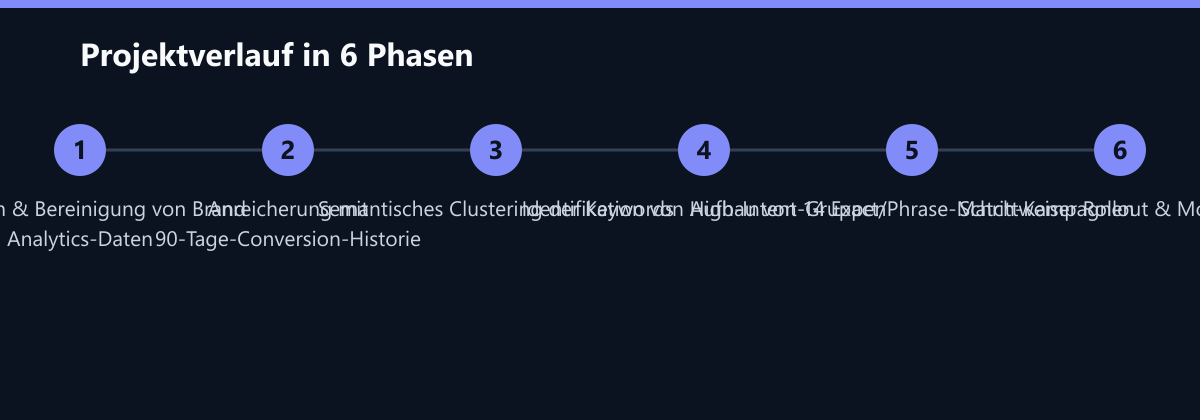
Anschließend kamen wir zum Kern der Methode: der algorithmischen Clusterung. Wir wandten ein semantisches Clustering-Modell an, um die Keywords nicht nur nach exaktem Text, sondern nach thematischer Ähnlichkeit und Suchintention zu gruppieren. Dies erlaubte es uns, „High-Intent“-Cluster zu identifizieren, deren Conversion-Rate deutlich über dem Durchschnitt lag. Gleichzeitig wurden „Low-Intent“-Cluster isoliert, die zwar viel Traffic generierten, aber kaum zu Verkäufen führten. Diese Differenzierung war der Schlüssel, um das Budget dorthin zu lenken, wo es sich auszahlt. Die bestehende Broad-Kampagnenstruktur wurde in 14 spezialisierte Exact- und Phrase-Match-Kampagnen aufgeteilt. Für jedes Cluster wurden individuelle Gebote basierend auf dem identifizierten Potenzial gesetzt. Gleichzeitig wurden pro Cluster spezifische negative Keyword-Listen erstellt, um die identifizierten Budget-Lecks zu stopfen. In Woche 1 und 2 lief dieser Datenimport und die Clusterung parallel zur laufenden Kampagne, um die Kontinuität des Umsatzes sicherzustellen. In Woche 3 erfolgte der schrittweise Rollout der neuen Struktur, beginnend mit den Clustern mit dem höchsten potenziellen ROI.
Ergebnis: Wirtschaftlichkeit und Effizienz im Doppelpack
Nach der vollständigen Umstellung der Kampagnenstruktur und einer Stabilisierungsphase von 60 Tagen zeigte sich eine deutliche Verbesserung der Wirtschaftlichkeit. Die Kosten pro erworbener Kunde (CAC) sanken signifikant, während der Gesamtwohn Umsatz stabil blieb und teilweise sogar zulegte. Die Präzision der Targeting-Strategie führte dazu, dass weniger Geld für „Fehlstarts“ ausgegeben wurde. Die internen Teams konnten sich auf strategische Aufgaben konzentrieren, da die operative Pflege der Kampagnen stark automatisiert wurde.
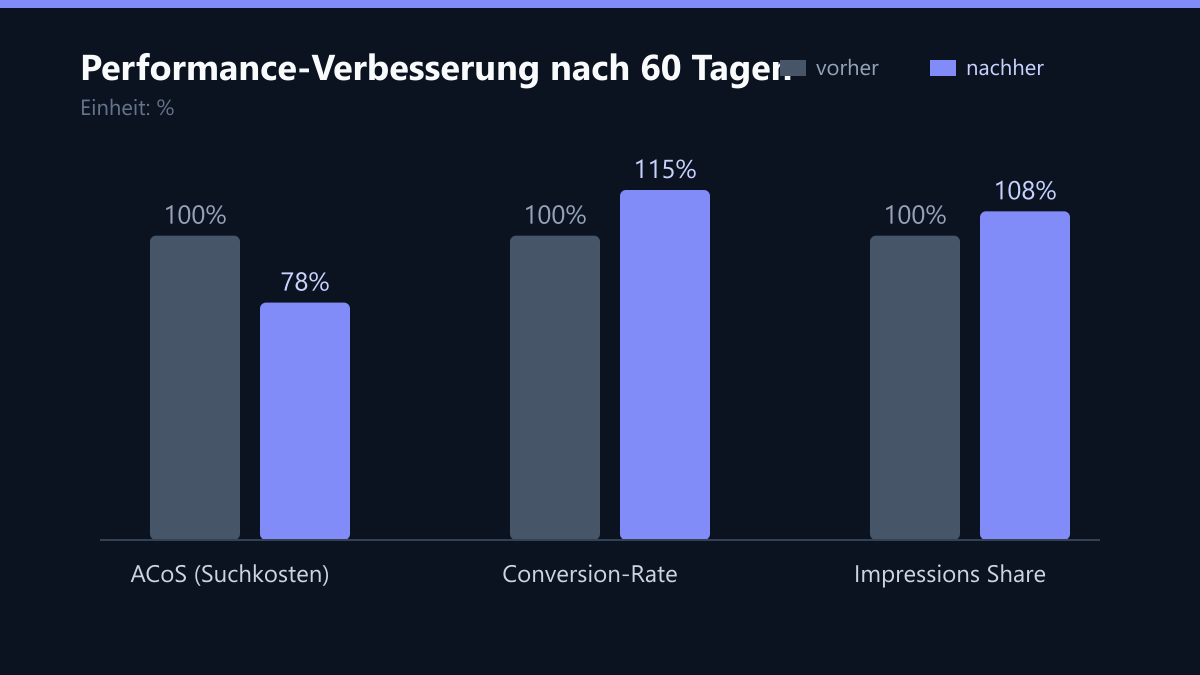
Die konkreten KPI-Veränderungen nach den ersten 60 Tagen im Vergleich zur Basisperiode waren wie folgt:
- Suchkosten (ACoS): Eine Reduktion um 22 % gegenüber dem Vorher-Nachher-Vergleich.
- Conversion-Rate: Eine Steigerung um 15 %, angetrieben durch die gezieltere Traffic-Qualität in den High-Intent-Clustern.
- Impressions Share: Ein Anstieg um 8 % in den identifizierten High-Intent-Clustern, da die Gebote hier aggressiver und präziser gesetzt werden konnten.
- Manuelle Arbeitszeit: Die manuelle Pflege der Kampagnen reduzierte sich für das interne Team um ca. 10 Stunden pro Woche.
Zusätzlich lieferten die neuen Cluster-Listen eine wertvolle Roadmap für die Produktentwicklung. Sie zeigten klar, welche spezifischen Beauty-Bedürfnisse und Nischen im Markt am stärksten nachgefragt wurden, was die Marketing- und Produktteams bei der Entwicklung neuer SKUs unterstützen konnte.
Was wir heute anders machen würden
Rückblickend sehen wir zwei Punkte, bei denen wir den Prozess noch weiter schärfen würden. Erstens: Die Integration der CRM-Daten hätte früher erfolgen sollen. In der ersten Woche hatten wir noch mit isolierten Amazon-Daten gearbeitet, was zu einem leichten Verzögerungseffekt bei der Identifikation der absoluten High-Value-Cluster führte. Eine frühere Anbindung hätte die Priorisierung noch präziser gemacht. Zweitens: Wir hätten die negativen Keywords in den Broad-Kampagnen noch aggressiver in der ersten Woche eingesetzt. Wir wollten zu vorsichtig vorgehen, um keine organische Sichtbarkeit zu verlieren, aber die Daten zeigten, dass die negativen Listen sofort hätten härter sein können, um die ACoS-Reduktion noch schneller zu beschleunigen.
Learnings: Warum Kontext schlägt Volumen
Der entscheidende Faktor für den Erfolg dieses Projekts war die Verbindung von Suchdaten mit tatsächlichen Verkaufsdaten. Reine Suchvolumen-Daten sind ohne Conversion-Kontext oft irreführend, da sie eine hohe Nachfrage suggerieren, die nicht in Umsatz mündet. Unsere wichtigsten Erkenntnisse aus diesem Projekt sind:
- Automatisierung ist skalierbar: Bei über 500 aktiven Keywords ist eine manuelle Priorisierung nicht mehr möglich. Nur algorithmische Clusterung erlaubt die Handhabung dieser Datenmenge.
- Clusterung statt Einzelbetrachtung: Keywords in thematische Gruppen zu fassen, erlaubt genauere Bidding-Strategien und ein besseres Budget-Management.
- Kontinuierliches Monitoring: Die Cluster sind kein statisches Ergebnis. Sie müssen monatlich neu bewertet werden, da sich Markt- und Saisonalitätsfaktoren ändern. Die Integration in das CRM-System ermöglicht es dem Kunden, die Strategie jetzt datenbasiert und in Echtzeit anzupassen.
Die datengetriebene Keyword-Clusterung ist kein einmaliges Projekt, sondern ein laufender Prozess, der die Effizienz des Amazon-Marketings nachhaltig sichert.
Passend dazu
- Performance-Marketing
- SEO & AI-Suche (GEO)
- A9-Algorithmus verstehen: So steigern Sie Produkt-Rankings durch Backend-Keywords
- ASIN-Optimierung: Organische Rankings durch A+ Content und Reviews steigern
- Affiliate-Marketing
- Content & CRO
- CRM-Marketing
- Reduzierung der CAC um 34 % durch LinkedIn-Abonnement-Kampagnen für eine DACH-Logistik-Plattform
- CPC-Senkung um 25 Prozent durch negative Keyword-Strategien im spanischen Finanzsektor
- Akquisekosten um 25 Prozent senken durch strukturierte Daten für KI-Suchmaschinen
- Senkung der Customer Acquisition Cost um 22 % durch automatisiertes Re-Engagement
- Maschinenbauer senkt Akquisekosten um 35 Prozent durch AI-Search-Integration
- Lokale SEO für Zahnarztgruppe in München: 150 Prozent mehr Terminbuchungen durch FAQ-Schema
- Skandinavischer E-Commerce-Händler reduziert Lagerbestandskosten um 15% durch dynamische Amazon Ads-Budgets
- 35 Prozent Umsatzsteigerung im Zalando-Shop für skandinavischen D2C-Schuhhersteller
- Messung von echtem ROAS auf Amazon durch CRM-Anbindung
- Content-Adaption für LLMs: Von Keyword-Dichte zu semantischer Konsistenz
- Reduktion der Lagerkosten um 18% durch datengetriebene Forecasting-Integration zwischen Amazon Vendor Central und ERP-Systemen in Benelux
- Vom Amazon FBA zur eigenen Marke: Wie ein DACH-Haushaltsgeräte-Hersteller seinen TACOS auf 320 % steigerte
- 32 Prozent Umsatzsteigerung im D2C-Modehandel durch verhaltensbasierte Journeys
- Reduzierung der Datenmigration-Zeit um 60% durch iPaaS-Integration im DACH-Mittelstand
- Reduktion der Webinar-Abbruchrate um 32 % durch HubSpot-Trigger und segmentierte Follow-up-Sequenzen im DACH-Mittelstand
- Rechtliche Rahmenbedingungen für die Moderation von Brand-Communities in der EU